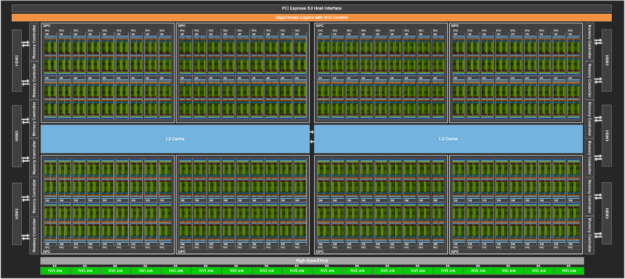
从封装到 SM,看清一颗 GPU 的组成。
以 H100 为真实案例;其他 GPU、NPU 或 SoC 的组织方式可能不同。
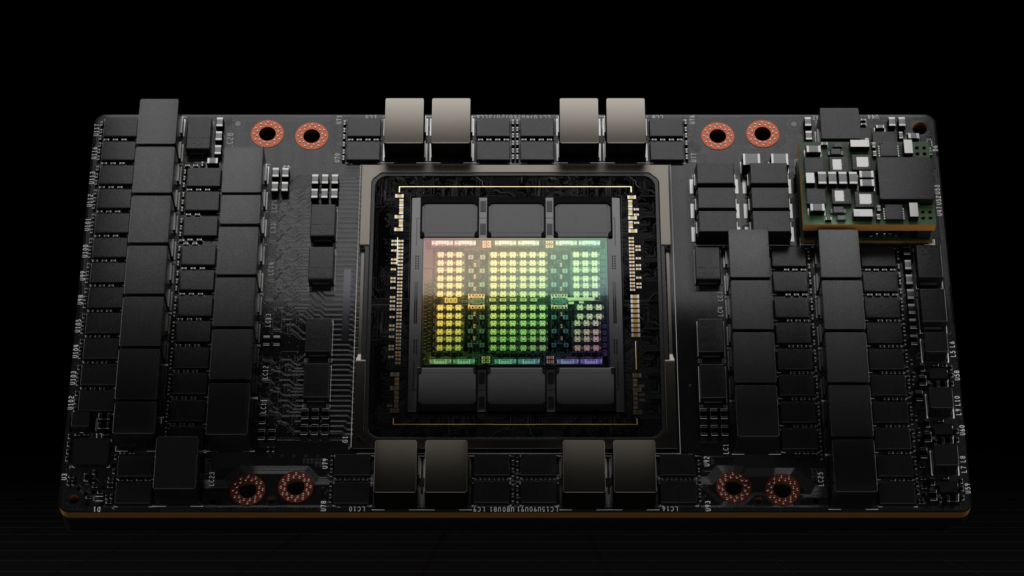
- 计算阵列:GPC → TPC → SM
- SM 内包含线程调度、寄存器、CUDA 运算单元和 Tensor Core。标量运算与矩阵乘加有不同吞吐,不能把 Tensor 峰值当作任意算子的速度。
- 片上存储:寄存器、Shared Memory / L1、L2
- 内核的数据复用与访存合并影响有效算术强度;寄存器和共享内存占用也会约束并发驻留。
- 封装存储:HBM 与内存控制器
- HBM 位于封装内、逻辑裸片之外。容量关系到模型能否放下,带宽关系到数据供给,不能混成一个指标。
- 系统连接:PCIe 与 NVLink
- 分别连接主机或其他设备,具体路径由平台拓扑决定;计算、通信、数据传输是否重叠影响端到端性能。
展开官方 SM 内部结构图
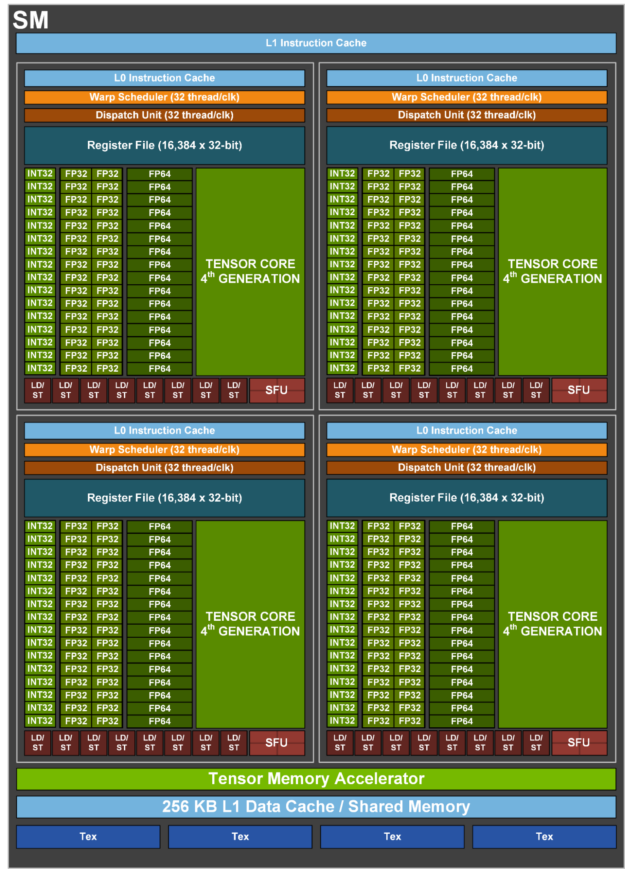
图片与架构说明:NVIDIA Hopper Architecture In-Depth(2022)。图示用于理解架构,不引用文章中的早期预测跑分作当前规格。
从分类出发,认识代表产品。
先选择分类维度,再看每个类别的代表产品、对应图示与选择理由。
GPU 是计算架构,推理 是任务,数据中心 是部署位置,PCIe 卡 是产品形态。它们可以同时描述一款产品。
延伸阅读:IBM · 什么是 AI 芯片
先问做什么,再问用什么。
不存在适合所有任务的万能芯片。换一个应用场景,关注的指标也会变化。
延伸阅读:IBM · AI 基础设施 · NVIDIA · 大模型推理的不同阶段
算力数字之外,还有什么?
性能是芯片、模型和软件共同作用的结果。先读懂指标,再判断它能说明什么。
小实验:模型权重需要多少内存?
B 表示十亿个参数。同样的参数量,位宽不同,权重占用也不同。这里仅估算权重本身。
7 × 10⁹ × 16 ÷ 8 = 14 × 10⁹ 字节
不含 KV Cache、激活、运行时、量化元数据等开销;不是显卡选购或“能运行”的结论。比较跑分前,把条件放在一起。
核对模型与版本、数值精度、稀疏口径、批量大小、输入输出长度、软件版本、设备数量和功耗条件。峰值 TOPS / TFLOPS 不能直接换算为实际任务速度。
一颗芯片的背后,是一整条产业链。
从设计工具到应用落地,点击一个环节,了解它交付什么,又依赖谁。
驱动与编译器 → 计算库与算子 → AI 框架 → 模型部署与运维。硬件能力需要通过软件被应用使用。
这是按功能组织的简化图,存储、封装、系统设计等环节会协同迭代,并非严格单向流水线。
延伸阅读:ASML · 芯片如何制造 · TSMC · 开放创新平台
现在,把概念对应到产品。
按厂商、种类、场景和形态,查看已有芯片条目及官方资料。
国内厂商,以及 NVIDIA、AMD、Qualcomm。产品参数沿用各条目的核查日期,不代表实时在售。
你可能还想问
把容易混淆的概念,再分清一点。
NPU 可以替代 GPU 吗?
取决于任务和软件支持。NPU 通常为神经网络运算优化,GPU 则支持广泛的并行计算。模型、算子、精度及部署工具是否适配,比名称更能决定某项任务能否迁移。
训练和推理,到底差在哪里?
训练用数据调整模型参数;推理使用已经训练好的模型处理新输入。微调也属于训练。两者都可能运行在 GPU 上,但对内存、计算和时延的要求会随任务变化。
芯片、加速卡和服务器,是一回事吗?
芯片是核心计算器件;加速卡把芯片、内存、供电及接口等组织在板上;服务器还包含 CPU、系统内存、网络、存储与散热。多个服务器又可以组成集群。不同层级的容量和功耗不能混为一谈。
“存算一体”属于 GPU 还是 NPU?
它描述计算与存储如何结合的技术路线,与 GPU、NPU 的分类维度不同。具体产品可能采用混合设计,应查看其实现方式、支持的模型和实测结果,不能只凭标签判断性能。
支持一个框架,就能运行它的全部模型吗?
不一定。还要核对算子覆盖、模型结构、版本、数据类型与动态形状等条件,部分模型需要转换、量化或适配。目录中的软件生态标签只是查找起点。